Prédiction des prix immobiliers (DVF)
Exploration et nettoyage de la base DVF des transactions immobilières en France, puis comparaison de modèles de régression (k plus proches voisins, Random Forest…) pour prédire la valeur foncière d'un bien.
- Python
- pandas
- NumPy
- scikit-learn
- Matplotlib
- Jupyter
La base DVF (Demandes de valeurs foncières) recense toutes les transactions immobilières réalisées chaque année en France. À partir de sa partie résidentielle, l'objectif était de prédire la valeur foncière d'un bien à partir de ses caractéristiques : département, surface bâtie, nombre de pièces, surface du terrain et position géographique.
Explorer et nettoyer les données
Le tableau de corrélations ne montrait aucun lien satisfaisant entre la valeur foncière et les autres attributs : il fallait d'abord comprendre les données.
- Création d'un attribut prix au mètre carré, qui fait ressortir les valeurs aberrantes : au-delà du 99ᵉ centile (environ 13 500 € le m²), les transactions faussent les prédictions.
- Recodage des départements corses 2A et 2B en valeurs numériques, en vérifiant que les statistiques étaient conservées.
- Traitement des valeurs manquantes : une surface de terrain absente devient 0, les lignes sans surface bâtie sont supprimées.
Visualiser
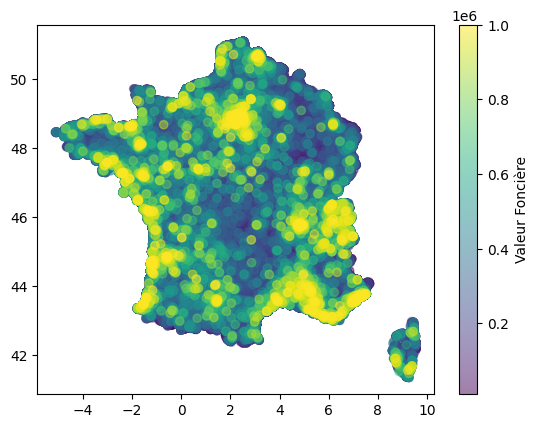
Une fois les valeurs extrêmes écartées, la carte des transactions colorées par valeur foncière fait apparaître les grandes métropoles et les côtes. Elle montre surtout que des biens proches, par leur position et leur surface, ont des prix voisins.
Entraîner et comparer des modèles
Cette observation a orienté le premier modèle vers les k plus proches voisins. Une fonction de test commune répète l'entraînement sur des découpages aléatoires et permet de choisir la part de valeurs extrêmes à retirer : retirer 10 % des prix au m² les plus élevés donnait les meilleurs résultats, avec 5 à 10 voisins.
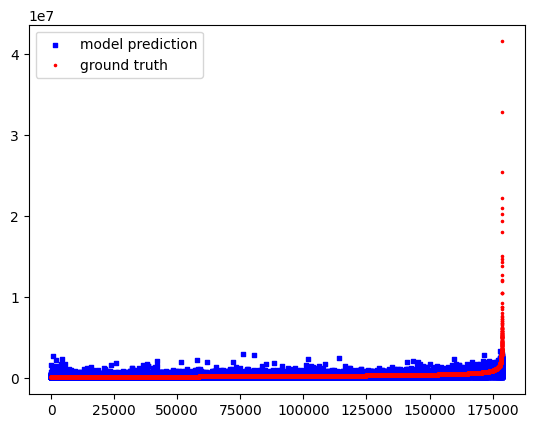
Le modèle prédit bien la grande majorité des biens, mais pas les biens aux prix exceptionnels, écartés de l'entraînement.
Nous avons ensuite comparé d'autres modèles de scikit-learn : régression linéaire, Lasso, ElasticNet, SGD (avec et sans normalisation), Random Forest et Gradient Boosting. La plupart obtiennent des erreurs proches. Les régressions linéaires sont les plus rapides, Random Forest et Gradient Boosting les plus précis.